你该自托管 LLM 吗?
先明确任务,再考虑 GPU。自托管适用于需要控制推理路径、有合适模型且有维护能力的情况。省钱则是需要单独验证的假设。 下方四个问题分别检查数据控制、工作负载、模型质量与运维责任。低使用量也可能因隐私而值得部署;高使用量也会因模型不合格而失败。
什么是自托管 LLM?
自托管 LLM 指在自己负责管理的基础设施上运行推理,可以是工作站、服务器或租用算力。你加载权重并决定应用如何访问运行时,不需要从零训练模型。 模型、推理运行时和应用是不同层次。聊天界面可能连接本地推理,也可能连接外部 API。只有相关处理都遵守预定边界,才能称为完整的本地处理。
如何自托管 LLM:先做 Docker 试点
从一个运行时、一个小模型和一个聊天界面开始。模型服务保留在容器网络中,持久化数据,在建立推理基线前不要对外开放。参考配置通过服务名连接 Open WebUI 和 Ollama。 平台页签说明系统差异,不会把 CPU 配置变成 GPU 部署。先验证基础路径,每次只改变一个加速设置。一次成功不能证明生产容量。
参考环境为 Docker Engine 和 Compose,配置默认仅使用 CPU。NVIDIA 加速需兼容驱动、Container Toolkit 和 GPU 资源配置,安装容器不会自动启用 GPU。
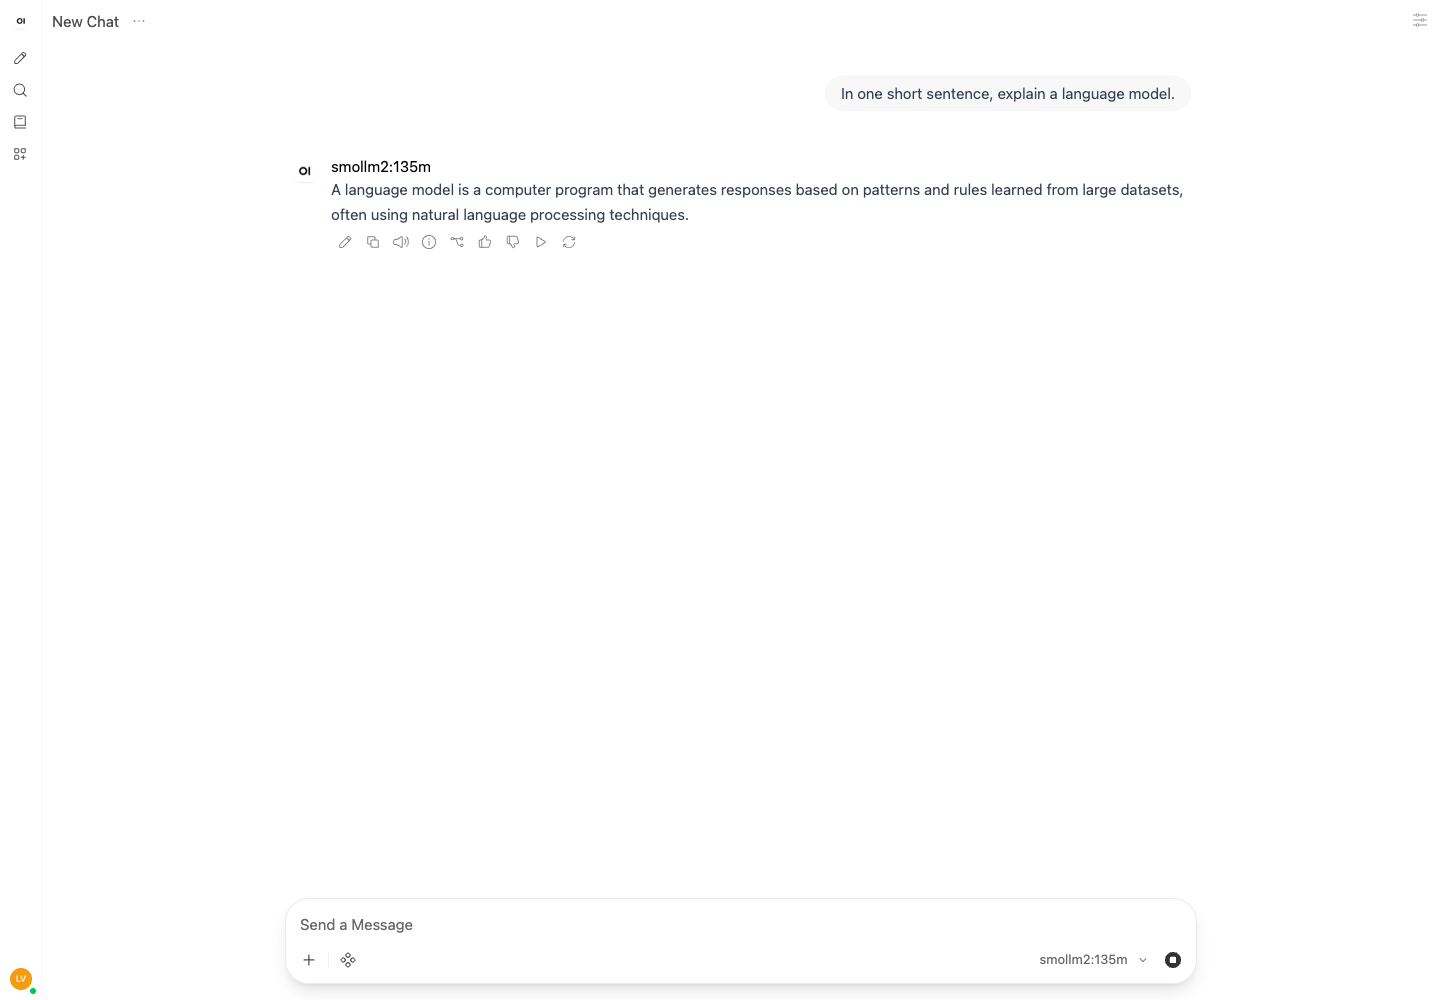
双容器 CPU 参考配置已核对官方文档,尚未完成端到端验证。另一次 macOS 冒烟测试使用原生 Ollama 0.34.3 与 Docker Open WebUI 0.12.3,记录日期为 2026-10-23;它不能证明 Linux GPU 性能或独立显存需求。
创建独立试点目录
将下方 compose 文件下载到这个目录。界面使用 3080 端口,以免与本站冲突。
mkdir llm-pilot
cd llm-pilot
docker version
docker compose version
Docker 客户端与服务端都响应,Compose 显示版本。
设置稳定的应用密钥
启动前创建本地环境文件,妥善保管,并在更新容器时保持同一个密钥。
umask 077
printf "WEBUI_SECRET_KEY=" > .env
openssl rand -hex 32 >> .env
docker compose config --quiet
Compose 校验成功,没有缺失密钥错误。密钥仅保存在本地 .env 中。
启动运行时并下载小型测试模型
下载需要联网和磁盘空间。先用小模型验证连通性,不代表它满足你的任务质量。
docker compose up -d
docker compose exec ollama ollama pull llama3.2:1b
docker compose exec ollama ollama run llama3.2:1b "Reply with: ready"
下载完成,推理返回文字。实际措辞和速度会不同。
验证界面并保存运行证据
打开 http://localhost:3080,创建本地账户并选择模型。使用合成提示词,记录镜像摘要、系统、上下文和并发。Mac 的容器内存不是 GPU 显存。 若模型不支持工具调用,先在 Workspace → Models → Edit → Capabilities 中关闭 Builtin Tools,再测试聊天。
docker compose ps
docker compose images
docker compose exec ollama ollama --version
docker compose exec ollama ollama ps
docker stats --no-stream
界面连接到模型,聊天返回文字,版本与内存观测可保存。
# Reference CPU-only stack. No model port is exposed to the host.
# Replace image tags with validated digests before production use.
services:
  ollama:
    image: ${OLLAMA_IMAGE:-ollama/ollama:latest}
    volumes:
      - model-data:/root/.ollama
    restart: unless-stopped
  webui:
    image: ${WEBUI_IMAGE:-ghcr.io/open-webui/open-webui:main-slim}
    ports:
      - "127.0.0.1:3080:8080"
    environment:
      OLLAMA_BASE_URL: http://ollama:11434
      WEBUI_SECRET_KEY: ${WEBUI_SECRET_KEY:?Set WEBUI_SECRET_KEY in .env}
    volumes:
      - chat-data:/app/backend/data
    depends_on:
      - ollama
    restart: unless-stopped
volumes:
  model-data:
  chat-data:
官方参考: Ollama Docker · Open WebUI Quick Start
计算自己的成本自己托管 LLM 到底更便宜吗?
比较相同任务和相近质量目标。检索问答往往输入较长,聊天可能输出较多,混合 token 单价容易失真。把实际要付出的基础设施、维护和迁移成本全部填入。 包月 GPU 即使闲置仍需付费。有效利用率解释单位完成请求的成本,不会减少固定账单。可暂停的按小时实例也需计入空闲计费时间。计算器固定一套部署成本,超过容量假设就停止认定它可行。
默认值仅为示例,不是实时价格。固定容量的比较假设任务质量相近,请替换为自己的报价和负载测试容量。
1. API 工作负载
2. 自托管账单
当前月请求量: 30,000. 距离阈值还差: 265,455.
有效时间 / 付费时间: 16.7%
容量内没有可达的盈亏平衡点,或 API 单价为零。请先调整假设。
查看公式与利用率说明
API = 30 × 日请求数 ×(输入 token × 输入单价 + 输出 token × 输出单价)/ 1,000,000。暂不建模缓存折扣和批处理价。
自托管 = GPU 固定月租,或小时价 × 计费小时,再加运维及迁移月摊销。有效时间不能给包月账单打折;按小时需计入空闲但仍计费的时间,有效小时不应超过付费小时。
平衡请求数 = 向上取整(月托管成本 / API 单请求成本),仅在测得容量内成立。这是成本交点,不是回本日期,也不代表两种模型质量相同。按每月 30 天计算。
对比十档月请求规模
| 每月请求数 | API 月成本 | 自托管月成本 | 容量假设 |
|---|---|---|---|
| 10,000 | $22.00 | $650.00 | 在假设容量内 |
| 50,000 | $110.00 | $650.00 | 在假设容量内 |
| 100,000 | $220.00 | $650.00 | 在假设容量内 |
| 250,000 | $550.00 | — | 需要扩容 |
| 500,000 | $1,100.00 | — | 需要扩容 |
| 1,000,000 | $2,200.00 | — | 需要扩容 |
| 2,500,000 | $5,500.00 | — | 需要扩容 |
| 5,000,000 | $11,000.00 | — | 需要扩容 |
| 10,000,000 | $22,000.00 | — | 需要扩容 |
| 30,000,000 | $66,000.00 | — | 需要扩容 |
自托管 LLM 硬件:别只算权重
权重存储只是起点。量化元数据、运行时工作区、注意力实现、上下文和并发都会影响峰值。MoE 的活跃参数描述计算量,不代表需要保存的完整权重。 表格只是数学估算,不是硬件推荐。另算 KV cache 和运行时余量,再测量。比较配置时固定提示词、生成长度与并发;统一内存、主机 RAM 和独立显存不是同一个指标。
| 参数量 | 4-bit | 8-bit | 16-bit |
|---|---|---|---|
| 3B | 1.4 GiB | 2.8 GiB | 5.6 GiB |
| 8B | 3.7 GiB | 7.5 GiB | 14.9 GiB |
| 14B | 6.5 GiB | 13.0 GiB | 26.1 GiB |
| 32B | 14.9 GiB | 29.8 GiB | 59.6 GiB |
| 70B | 32.6 GiB | 65.2 GiB | 130.4 GiB |
权重 GiB = 参数量 × 每参数位数 ÷ 8 ÷ 2³⁰。量化元数据、运行时缓冲和 KV cache 需另外计算;装得下不代表达到性能目标。
添加服务前,先画数据路径
单人使用可能只需要界面与运行时。团队使用要先明确身份、权限边界和可观测性,再增加组件。向量数据库、Agent 框架和集群编排都需要实际理由。 画清提示词、文档、嵌入、日志和输出流向,标出每一次外部连接和身份。架构图应帮助你确定在哪里限制请求、检查权限与执行删除。
访问边界
用户 → 身份验证 → 网关。推理端点保持私有;本地配置只将界面绑定到回环地址。
模型服务
网关 → 运行时 → 模型权重。根据实测需求设置上下文、并发与队列,不按宣传的最大上下文配置。
数据与检索
有需要再加检索。文档进入模型上下文前执行权限检查,并保持删除和保留策略一致。
公开部署前的十二项检查
自托管转移了责任,不会自动带来隐私或合规。试点先只绑定回环地址。远程使用前检查下列项目;命令仅用于检查此参考配置,不是控制措施有效的通用证明。 应用权限需要反向测试,备份需要真实恢复。容器显示运行正常无法证明这两件事。
检查暴露端口
试点只应把界面绑定到宿主机回环地址,模型端口不应出现在已发布端口中。开放远程访问前还需从其他设备验证。
docker compose ps要求应用身份验证
验证未登录请求不能读取聊天或执行模型操作。一次重定向不足以证明授权有效。
curl -I http://127.0.0.1:3080/保持应用密钥稳定
确认文件存在,但不要把密钥打印到共享日志。轮换需明确会话和恢复方案。
test -s .env && echo "Environment file exists"记录镜像确切版本
保留镜像摘要,更新前阅读上游变更。浮动标签适合试点,不是可复现基准。
docker compose images检查监听进程
确认本地监听进程以及代理是否改变访问边界。Windows 需使用对应的主机工具。
lsof -nP -iTCP -sTCP:LISTEN分开模型与聊天存储
确认持久卷已挂载。容器若未使用预期卷,替换时可能丢失数据。
docker volume ls --filter name=llm检查日志敏感信息
使用合成提示词在本地检查。分享前删除 token、用户内容与身份信息。
docker compose logs --tail=50验证文档权限
使用权限不同的两个用户,验证 A 的受限文档不会被 B 检索出来。进程状态不能证明权限。
# Manual negative test: two users, one restricted document设置请求和队列限制
检查应用网关的超时、并发和输入长度策略,再使用合成数据测试预定限制。
docker compose exec ollama ollama ps测量资源压力
分别观察空闲和活跃状态。容器内存不是 GPU 显存,GPU 需使用设备遥测。
docker stats --no-stream验证备份恢复
停止写入或使用应用一致性备份,在独立项目恢复,不要删除原卷来测试。
# Record backup identifier, isolated restore result and recovery time检查远程入口与回退
试点保持本地私有。远程使用前,从另一客户端验证身份、TLS、防火墙和回退。
# Manual external check: only intended authenticated entry points respond先测请求,再测队列
区分首 token 延迟、生成速度与端到端延迟。单请求快,不代表多用户同时到达时也快。预填充、解码、批处理和内存压力影响不同阶段。 使用有代表性的任务集,固定输入输出长度,分别记录冷启动和热运行,再逐渐提高并发并观察延迟分位数与错误率。按任务实测选择运行时,不照搬其他硬件的速度。
查看部署参考购买硬件、按小时租用还是包月?
自有硬件包括购买、电力、散热、更换与管理成本。按明确使用寿命摊销购买价,并计入整机。讨论长期总成本时,已有 GPU 也不能直接按零计算。 按小时租用适合间歇任务的前提是确实可以停止计费。包月账单稳定但低使用量可能昂贵。托管私有部署用服务费换取部分运维工作,比较时需看支持范围与最低承诺。
查看部署参考最适合的模型取决于任务
用实际工作构建小型测试集,例如信息提取、基于资料回答、代码修改。比较前定义合格答案与失败条件,同时验证许可、工具调用和格式约束。 每次只改变一个变量。在同样内存与延迟预算下比较模型版本、量化和提示格式,保存稳定基线。排行榜可以提供候选,但不能替代评测。
第一次聊天成功后要记录什么?
记录镜像摘要、模型标识与版本、量化、操作系统、驱动、运行时配置和提示词。每次内存观测都附上上下文和并发。缺少这些条件的截图很难复现。 验证正常重启后数据仍在,导出备份并在隔离环境恢复。记录加载失败、超时与队列饱和。更新前跑同一测试集,并保留回退路径。
查看部署参考哪些情况不适合自己托管 LLM?
没有模型满足质量、无人维护,或预算内达不到延迟目标时,应先暂停。便宜但失败的请求不是节省。低使用量或波动大的任务可能更适合 API,但不存在通用的每日 token 分界线。 隐私约束可能优先于成本,也可能禁止外部回退。设计混合架构前写清边界,不能通过默默外发敏感数据解决容量问题。
查看部署参考自托管、API 与混合架构怎么选?
把质量、数据处理、延迟、容量、可用性与总成本分开评估。自托管改变运营责任,不会移除资源限制。API 减少基础设施工作,但应用仍需监控和用量控制。 混合路由要明确哪些请求允许外发、失败怎么处理、成本如何归因。三种方案使用相同任务评测,让比较回答自己的问题。
外部 API
适合作为质量与成本基线。分别计量输入输出,评估限流与供应商的数据政策。
自托管
你选择运行时、权重和基础设施,也负责容量、权限、更新、备份与恢复。
混合架构
按规则路由任务。外部 API 回退必须遵守原请求的数据边界。
先运行一个试点,保留证据。
选择一个实际任务和明确的数据边界,完成判据卡,填入自己的成本,再运行一个小规模试点。购买容量或迁移用户前,先保存运行证据。 如果仍无法决定,找出缺少的事实:任务质量、峰值并发、响应时间,或真实托管账单。下一步去测量它,而不是继续添加服务。
本文是技术参考,不是性能实测报告。命令需在你的系统与硬件上验证。成本输入为示例美元假设,并非实时供应商报价。网页不会创建付费基础设施。